


Cách Xử Lý Dữ liệu Thô Trong Data Pipeline: Từ Raw Data Đến Insight
Xử lý dữ liệu thô là tập hợp các bước trong data pipeline để biến đổi dữ liệu nguồn chưa chuẩn hóa (raw data) thành định dạng sạch, nhất quán, sẵn sàng phân tích. Quy trình này bao gồm thu thập (Extract), kiểm tra chất lượng (Validate), chuyển đổi (Transform), tải vào kho dữ liệu (Load) và giám sát liên tục (Monitor).
Thực tế, các doanh nghiệp lớn như Otto Group (nhà bán lẻ e-commerce lớn thứ hai châu Âu) đã phải tích hợp hơn 80 microservices vào pipeline của họ để xử lý dữ liệu từ nhiều nguồn khác nhau [1]. Trong khi ETL truyền thống từ những năm 1990 chỉ tải dữ liệu một lần mỗi ngày [2], các hệ thống hiện đại đòi hỏi xử lý gần thời gian thực với độ phức tạp cao hơn nhiều.

Mục lục
I. Xử lý dữ liệu thô là gì?
Dữ liệu thô (raw data) là dữ liệu ở dạng gốc, chưa qua làm sạch hay chuẩn hóa. Có thể là file CSV từ bộ phận bán hàng ghi nhầm định dạng ngày tháng, JSON từ API bên thứ ba thiếu vài trường bắt buộc, hoặc log hệ thống chứa ký tự đặc biệt.
Xử lý dữ liệu thô biến những dữ liệu này thành dạng có thể sử dụng được: định dạng thống nhất, loại bỏ trùng lặp, điền giá trị thiếu theo logic nghiệp vụ, và tích hợp từ nhiều nguồn vào một kho dữ liệu chung. Không có bước này, analyst sẽ mất hàng giờ để làm sạch thủ công trước khi phân tích được gì.
Trong kiến trúc dữ liệu hiện đại, xử lý dữ liệu thô diễn ra trong data pipeline, một chuỗi các bước tự động hóa từ nguồn dữ liệu đến điểm đích cuối cùng (data warehouse, data lake, hoặc dashboard). Pipeline không chỉ chuyển dữ liệu, mà còn đảm bảo chất lượng, ghi log, và cảnh báo khi có lỗi.
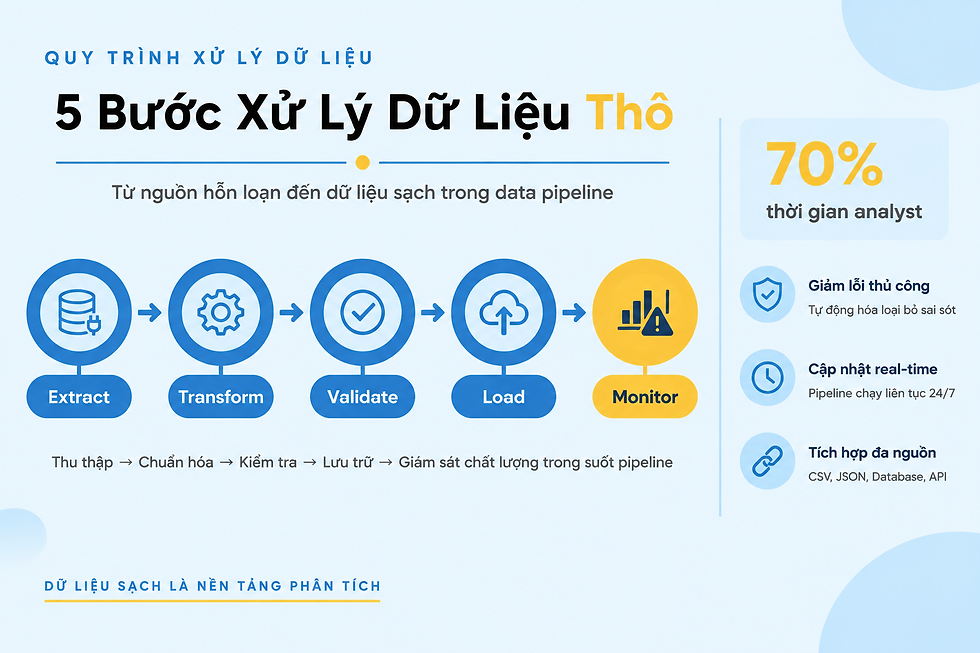
II. Quy trình xử lý dữ liệu thô: 5 bước cốt lõi
1. Extract - Thu thập từ nguồn
Extract là bước đầu tiên, lấy dữ liệu từ các nguồn khác nhau về một nơi xử lý tập trung. Nguồn có thể là:
Database: kết nối trực tiếp qua JDBC, ODBC để đọc bảng từ PostgreSQL, MySQL, SQL Server
API: gọi REST API hoặc GraphQL để lấy dữ liệu từ hệ thống CRM, ERP, dịch vụ bên thứ ba
File: đọc CSV, Excel, JSON, Parquet từ shared drive, FTP, hoặc cloud storage (S3, Azure Blob)
Streaming source: kết nối Kafka topic, message queue để nhận event real-time
Thách thức ở bước này là xử lý tốc độ và khối lượng dữ liệu khác nhau. Một số nguồn trả về vài nghìn dòng mỗi ngày, một số khác phát sinh hàng triệu event mỗi giờ. Pipeline cần thiết kế đủ linh hoạt để thu thập cả hai.
Kỹ thuật phổ biến là incremental extraction, chỉ lấy dữ liệu thay đổi kể từ lần chạy trước (dựa vào timestamp hoặc ID tăng dần) thay vì tải lại toàn bộ. Điều này giảm tải cho hệ thống nguồn và tăng tốc pipeline.
2. Validate - Kiểm tra chất lượng
Sau khi thu thập, dữ liệu cần được kiểm tra trước khi xử lý tiếp. Validate đảm bảo dữ liệu đủ tốt để pipeline không bị fail giữa chừng hoặc tạo ra kết quả sai.
Ba loại kiểm tra chính:
Schema validation: kiểm tra kiểu dữ liệu (cột ngày có đúng là date, cột số có phải numeric), số lượng cột khớp với kỳ vọng, tên cột không thay đổi đột ngột
Null check: xác định cột nào được phép null, cột nào bắt buộc có giá trị (ví dụ customer_id, order_date không được thiếu)
Duplicate detection: tìm các bản ghi trùng lặp dựa trên primary key hoặc business key
Pipeline thường thiết lập ngưỡng cho phép: chấp nhận dưới 5% missing values trong cột không quan trọng, nhưng fail ngay nếu cột khóa thiếu hơn 0.1%. Các record fail được ghi vào quarantine table để xem xét thủ công sau.
Công cụ như Great Expectations hoặc Deequ giúp định nghĩa các rule validation dưới dạng code, chạy tự động mỗi khi pipeline thực thi.
3. Transform - Chuẩn hóa dữ liệu
Transform là bước phức tạp nhất, biến đổi dữ liệu thô thành dạng phù hợp với mô hình phân tích. Ba thao tác chính:
Cleaning: sửa lỗi, loại bỏ nhiễu, chuẩn hóa định dạng. Ví dụ:
Chuyển "01/12/2025", "12-01-2025", "2025/01/12" về cùng format "2025-01-12"
Trim khoảng trắng thừa trong text
Thay thế giá trị outlier bất thường (giá âm trong cột revenue) bằng null hoặc median
Enrichment: bổ sung thông tin từ nguồn khác. Ví dụ:
Join với bảng địa lý để thêm cột region từ city name
Gọi API để lấy tỷ giá hối đoái theo ngày
Tính toán các metric mới (revenue_per_customer, churn_risk_score)
Aggregation: tổng hợp dữ liệu chi tiết lên mức độ phân tích cần thiết. Ví dụ:
Group by date, product_id để tính total_sales theo ngày và sản phẩm
Window function để tính running total, moving average
Pivot để chuyển dữ liệu dạng dọc sang ngang phù hợp với dashboard
Một kỹ thuật quan trọng là idempotency: pipeline cần đảm bảo chạy nhiều lần trên cùng dữ liệu cho kết quả giống nhau. Tránh các thao tác như "INSERT mà không kiểm tra trùng" hoặc "cộng dồn vào bảng kết quả" mà không xóa dữ liệu cũ.
4. Load - Đưa vào kho dữ liệu
Load đưa dữ liệu đã transform vào điểm đích cuối cùng: data warehouse (Snowflake, BigQuery, Redshift) hoặc data lake (Delta Lake, Iceberg). Hai chiến lược phổ biến:
Full load: xóa toàn bộ dữ liệu cũ và ghi lại từ đầu. Đơn giản nhưng chậm, phù hợp với bảng nhỏ (dimension tables, lookup tables).
Incremental load: chỉ thêm hoặc cập nhật dữ liệu thay đổi. Có ba pattern:
Append: chỉ thêm record mới (log table, transaction table)
Upsert: thêm record mới, cập nhật record đã tồn tại dựa trên key (customer profile, inventory)
SCD Type 2: giữ lịch sử thay đổi bằng cách thêm timestamp valid_from, valid_to cho mỗi phiên bản
Load cần tối ưu về mặt hiệu năng: batch nhiều record thành một transaction, sử dụng bulk insert API thay vì insert từng dòng, partition dữ liệu theo date hoặc region để query nhanh hơn.

5. Monitor - Giám sát pipeline
Pipeline không tự chạy mãi không lỗi. Giám sát liên tục giúp phát hiện sớm các vấn đề trước khi ảnh hưởng đến báo cáo.
Ba thành phần giám sát:
Alerting: thiết lập cảnh báo khi:
Pipeline fail hoặc chạy quá lâu so với baseline
Dữ liệu không về đúng giờ (late-arriving data)
Số lượng record giảm đột ngột hoặc tăng bất thường
Data quality rule vi phạm ngưỡng cho phép
Logging: ghi lại chi tiết mỗi lần chạy:
Số record được extract, transform, load thành công
Lỗi chi tiết nếu fail (error message, stack trace, sample bad records)
Thời gian thực thi từng bước để phát hiện bottleneck
Data lineage: theo dõi dữ liệu đi từ đâu, qua bước nào, đến đâu. Khi một con số trên dashboard sai, lineage giúp truy ngược lại nguồn gốc: lỗi từ API, transform logic sai, hay issue từ bảng nguồn.
Công cụ như Airflow, Prefect, Dagster cung cấp UI để xem pipeline run history, retry failed tasks, và visualize dependency graph giữa các bước.
III. ETL vs ELT vs Streaming: Chọn phương pháp nào?
Ba kiến trúc xử lý dữ liệu thô phổ biến, mỗi kiểu phù hợp với nhu cầu khác nhau.
1. ETL truyền thống (Batch processing)
ETL (Extract, Transform, Load) transform dữ liệu trước khi load vào warehouse. Dữ liệu được xử lý theo batch (hàng loạt), thường là một lần mỗi ngày vào lúc off-peak [2].
Ưu điểm:
Transform trên server riêng, không tốn tài nguyên warehouse
Dữ liệu đã sạch khi vào warehouse, query đơn giản
Phù hợp với on-premise infrastructure có giới hạn compute
Nhược điểm:
Latency cao: dữ liệu mới nhất chỉ có sáng hôm sau
Khó scale khi khối lượng tăng, cần nâng cấp ETL server
Logic transform nằm ngoài warehouse, khó maintain và audit
Dùng khi: doanh nghiệp có infrastructure on-premise, yêu cầu phân tích theo chu kỳ nhật/tuần, dữ liệu không cần real-time.
2. ELT hiện đại (Cloud-native)
ELT (Extract, Load, Transform) load dữ liệu thô vào warehouse trước, transform bằng SQL bên trong warehouse. Kiến trúc này trở nên phổ biến với các cloud data warehouse có khả năng compute mạnh như BigQuery, Snowflake, Redshift [2].
Ưu điểm:
Tận dụng sức mạnh compute của cloud warehouse, scale tự động
Transform bằng SQL, dễ version control và audit
Data scientist truy cập trực tiếp raw data để thử nghiệm
Nhược điểm:
Chi phí compute warehouse cao hơn nếu transform phức tạp
Cần thiết kế schema tốt để tránh warehouse trở thành "data swamp"
Phụ thuộc vào vendor (vendor lock-in)
Dùng khi: đã dùng cloud infrastructure, cần flexibility trong phân tích, có team quen SQL và DBT.

3. Streaming ETL (Near real-time)
Streaming xử lý dữ liệu liên tục theo từng event, thay vì batch theo giờ/ngày. Sử dụng các công nghệ như Apache Kafka, Flink, Spark Streaming.
Ưu điểm:
Latency thấp: insight gần real-time (vài giây đến vài phút)
Xử lý khối lượng lớn event với throughput cao
Phát hiện anomaly và cảnh báo ngay khi xảy ra
Nhược điểm:
Phức tạp về kiến trúc, cần team engineering mạnh
Chi phí infrastructure cao (cần cluster chạy 24/7)
Khó debug và troubleshoot khi có lỗi
Dùng khi: cần monitoring real-time (fraud detection, IoT sensor), khối lượng event lớn (click stream, log analysis), yêu cầu phản ứng tức thì.
IV. Công cụ xử lý dữ liệu thô phổ biến 2026
Open-source:
Apache Airflow: orchestration tool phổ biến nhất, định nghĩa pipeline bằng Python code, có UI để monitor. Phù hợp với batch ETL.
Apache Kafka + Flink: stack cho streaming data, Kafka làm message queue, Flink xử lý transform real-time.
DBT: tool ELT chạy transform SQL trong warehouse, version control bằng Git, test dữ liệu tự động.
Great Expectations: framework validation dữ liệu, định nghĩa expectation cho từng cột (range, uniqueness, distribution).
Commercial/Cloud-managed:
Fivetran, Airbyte: no-code/low-code connector, kết nối hàng trăm nguồn dữ liệu vào warehouse chỉ bằng vài click.
Azure Data Factory, AWS Glue: cloud-native ETL service, tích hợp chặt với ecosystem của từng cloud provider.
Databricks: nền tảng data + AI, xử lý cả batch và streaming, hỗ trợ Delta Lake để ACID transaction trên data lake.
Snowflake: data warehouse có tính năng Snowpipe để auto-ingest dữ liệu mới, task scheduling để chạy transform định kỳ.
Chọn công cụ dựa trên:
Skill team: nếu team mạnh Python thì Airflow + DBT, nếu ưa no-code thì Fivetran.
Infrastructure hiện tại: đã dùng AWS thì Glue và Redshift hợp lý, Azure thì Data Factory + Synapse.
Ngân sách: open-source tiết kiệm license nhưng cần effort maintain, managed service đắt hơn nhưng ít headache hơn.

V. Kỹ thuật nâng cao: CDC, CDM và Schema Evolution
1. Change Data Capture (CDC) cho hệ thống nhỏ
CDC là kỹ thuật capture những thay đổi trên database nguồn (insert, update, delete) và replicate sang hệ thống đích gần real-time. Thay vì full load toàn bộ bảng 10 triệu dòng, CDC chỉ lấy 100 dòng thay đổi trong 5 phút qua.
Cách triển khai phổ biến:
Log-based CDC: đọc transaction log của database (MySQL binlog, PostgreSQL WAL) để biết record nào thay đổi. Tool: Debezium (open-source), AWS DMS.
Trigger-based CDC: tạo trigger trên bảng nguồn để ghi thay đổi vào audit table, pipeline đọc từ đó.
Query-based CDC: query bảng nguồn với filter WHERE updated_at > last_run_time. Đơn giản nhưng tốn tài nguyên query.
CDC giảm đáng kể load time, từ hàng giờ xuống còn vài phút. Phù hợp với bảng transaction lớn, cần cập nhật thường xuyên vào data warehouse.
2. Canonical Data Model trong microservices
Canonical Data Model (CDM) là mô hình dữ liệu chuẩn chung, được sử dụng để tích hợp nhiều microservices có schema khác nhau. Pattern này được phát minh cho kiến trúc SOA (Service-Oriented Architecture) theo Forrester 2010, và nhận được sự chú ý trở lại trong bối cảnh microservices từ 2019-2020 [1].
Vấn đề: Khi có 80+ microservices như trường hợp của EOS [1], mỗi service có schema riêng. Nếu service A cần dữ liệu từ service B, C, D, phải viết 3 adapter khác nhau. Khi thêm service E, lại viết adapter mới. Độ phức tạp tăng theo tích số (n × m).
Giải pháp CDM: định nghĩa một schema chuẩn ở giữa, mỗi service chỉ cần map từ schema riêng sang CDM. Khi thêm service mới, chỉ viết một adapter duy nhất. Độ phức tạp giảm xuống tuyến tính (n + m) [1].
Thách thức của CDM là thiết kế schema chuẩn đủ tổng quát để cover nhiều use case, nhưng không quá phức tạp. Và cần automation để update mapping khi các service thay đổi schema [1].
3. Xử lý schema changes không downtime
Schema evolution là khả năng thay đổi cấu trúc dữ liệu mà không ảnh hưởng đến pipeline đang chạy. Ví dụ: API bên thứ ba thêm một field mới, hoặc đổi tên field cũ.
Ba chiến lược:
Backward compatibility: schema mới vẫn đọc được dữ liệu cũ. Ví dụ: thêm cột mới với default value, pipeline không cần sửa code.
Forward compatibility: schema cũ vẫn đọc được dữ liệu mới. Ví dụ: dữ liệu có field mới, pipeline cũ bỏ qua field đó.
Schema registry: dùng công cụ như Confluent Schema Registry để version control schema, validate compatibility tự động trước khi deploy. Các hệ thống streaming thường yêu cầu schema registry để tránh producer và consumer mismatch.
Automation là chìa khóa: thiết lập CI/CD để test schema changes trên staging environment, chạy compatibility check, và deploy tự động nếu pass. Ba vấn đề phức tạp chính là kích thước ma trận tích hợp, automation cập nhật, và hiệu quả thời gian [1].

VI. Best practices từ thực tế production
Error handling và retry logic:
Thiết kế pipeline để fail fast: phát hiện lỗi sớm, dừng ngay thay vì lan truyền dữ liệu sai xuống downstream.
Retry với exponential backoff: thử lại khi gặp lỗi tạm thời (network timeout, API rate limit), nhưng tăng khoảng cách giữa các lần retry (1s, 2s, 4s, 8s...).
Dead letter queue: đưa các record fail nhiều lần vào queue riêng để xử lý thủ công sau, không block toàn bộ pipeline.
Optimization cost và performance:
Chạy pipeline vào off-peak để giảm chi phí compute (cloud warehouse tính phí theo giờ sử dụng).
Partition dữ liệu theo date hoặc region, query chỉ scan partition cần thiết thay vì full table.
Chọn compression format phù hợp: Parquet cho dữ liệu columnar phân tích, Avro cho streaming, CSV chỉ dùng khi cần human-readable.
Cache các bảng lookup/dimension được join nhiều lần thay vì query lại mỗi lần.
Security và compliance:
Mã hóa dữ liệu nhạy cảm (PII: tên, email, số điện thoại) ngay từ bước extract, không lưu plain text vào log.
Implement row-level security: user chỉ thấy dữ liệu của region/department mình phụ trách.
Audit log: ghi lại ai truy cập dữ liệu gì, khi nào, để phục vụ compliance (GDPR, PDPA, etc.).
Backup dữ liệu định kỳ, test restore procedure để đảm bảo có thể phục hồi khi xảy ra sự cố.
Documentation và collaboration:
Document logic transform phức tạp bằng comment trong code hoặc mô tả trong data catalog.
Thiết lập naming convention nhất quán cho table, column, pipeline name để dễ tìm kiếm.
Tạo data dictionary giải thích ý nghĩa từng metric, cách tính toán, business rule liên quan.
Setup lineage visualization để team hiểu data flow end-to-end, từ nguồn đến dashboard.
VII. Câu hỏi thường gặp
1. ETL và ELT khác nhau ở điểm nào?
ETL transform dữ liệu trước khi load vào warehouse, ELT load dữ liệu thô vào warehouse trước rồi mới transform bằng SQL. ELT phổ biến hơn với cloud warehouse vì tận dụng được sức mạnh compute của chúng.
2. Nên xử lý missing values như thế nào?
Tùy context: nếu là cột quan trọng (customer_id), bỏ record đó hoặc gửi về quarantine. Nếu là cột phân tích (discount_amount), có thể điền 0 hoặc median. Không có quy tắc cứng, cần hiểu nghiệp vụ.
3. Data lake và data warehouse khác gì?
Data lake lưu dữ liệu thô ở mọi định dạng (structured, semi-structured, unstructured), chi phí lưu trữ thấp. Data warehouse lưu dữ liệu đã chuẩn hóa theo schema, tối ưu cho query phân tích. Thực tế nhiều công ty dùng cả hai: lake để lưu trữ, warehouse để phân tích.
4. Batch processing hay streaming, chọn cái nào?
Batch đủ cho phần lớn use case (báo cáo hàng ngày, phân tích xu hướng). Streaming chỉ cần khi yêu cầu real-time (fraud detection, monitoring hệ thống). Streaming phức tạp và đắt hơn, đừng over-engineering.
5. Làm sao biết pipeline đang fail?
Thiết lập monitoring với alert qua email/Slack khi pipeline fail hoặc chạy quá lâm. Xem log để debug, check execution history trên Airflow/Prefect UI. Nếu data missing, dùng lineage tool để trace ngược.
6. Dữ liệu đến muộn (late-arriving data) xử lý ra sao?
Có hai cách: 1) Reprocess toàn bộ batch để bao gồm dữ liệu muộn (tốn tài nguyên), 2) Chỉ update partition chứa dữ liệu muộn đó (phức tạp hơn nhưng hiệu quả). Tùy SLA của dashboard cần độ chính xác như thế nào.
7. Schema của API nguồn thay đổi, pipeline bị lỗi?
Implement schema validation ở bước extract để phát hiện sớm. Sử dụng schema registry nếu làm việc với streaming. Liên hệ team bên API để họ thông báo trước khi breaking change, hoặc version API để tránh bất ngờ.
8. Có nên dùng công cụ no-code như Fivetran?
Phù hợp nếu budget cho phép và cần deploy nhanh. No-code tool giảm effort maintain infrastructure. Nhưng khi cần custom logic phức tạp, vẫn phải viết code (Python, SQL). Hybrid approach thường là tốt nhất: dùng no-code cho connector, code cho transform.
9. Chi phí cloud warehouse cao, làm sao giảm?
Chạy pipeline vào giờ off-peak. Partition dữ liệu để query scan ít hơn. Xóa dữ liệu cũ không dùng hoặc archive sang cold storage. Tắt cluster khi không dùng (auto-suspend). Review query pattern để tối ưu.

VIII. Kết luận
Xử lý dữ liệu thô là nền tảng của mọi hệ thống phân tích. Quy trình năm bước Extract, Validate, Transform, Load, Monitor tạo ra pipeline ổn định, scale được, và dễ maintain. Chọn kiến trúc phù hợp (ETL, ELT, Streaming) dựa trên yêu cầu thực tế về latency, khối lượng, và skill team.
Ba hành động bạn có thể làm ngay:
Review pipeline hiện tại: có monitoring đầy đủ chưa, có alert khi fail không, log có đủ chi tiết để debug không?
Thiết lập data quality checks: định nghĩa expectation cho các cột quan trọng, chạy validation tự động mỗi lần pipeline thực thi.
Document data flow: vẽ sơ đồ lineage từ nguồn đến dashboard, giúp team mới onboard nhanh và troubleshoot dễ hơn.
Năm 2026, với sự phát triển của AI và cloud-native tools, xử lý dữ liệu thô đang trở nên dễ tiếp cận hơn. Nhưng nền tảng vẫn không thay đổi: hiểu rõ logic nghiệp vụ, thiết kế pipeline đúng cách, và giám sát liên tục.
Lưu ý: phần dưới đây giới thiệu chương trình đào tạo của Mastering Data Analytics.
📚 Bắt đầu sự nghiệp Analytics vững vàng trong kỷ nguyên AI
Mastering Data Analytics (MDA) là một trong những đơn vị đào tạo phân tích dữ liệu tại Việt Nam, mang chương trình Agentic AI Analytics đến với người học. Sau hơn 6 năm đào tạo phân tích dữ liệu, MDA đã đồng hành cùng 3.000+ học viên và 250+ doanh nghiệp lớn như Heineken, Prudential, P&G, AEON, BIDV, Coca-Cola, Unilever.Điểm khác biệt của MDA không nằm ở những lời hứa kiểu '5 phút phân tích data với ChatGPT' hay 'vibe coding dashboard'. Chúng tôi rèn đúng bộ ba tạo nên lợi thế cạnh tranh thật sự thời AI: tư duy phân tích hệ thống, chuyên môn vững chắc và năng lực điều phối AI Agents.
Khám phá chương trình: Agentic AI Analytics, Finance Analytics
Tư vấn lộ trình miễn phí qua Zalo: 0961 48 66 48
Fanpage: Mastering Data Analytics
Nguồn tham khảo
[1] METL - a modern ETL pipeline with a dynamic mapping matrix. https://ar5iv.labs.arxiv.org/html/2203.10289
[2] PDF Automating ETL Pipelines Using Artificial Intelligence: Transforming .... https://www.researchgate.net/profile/Aremu-Oluwaferanmi/publication/392551858_Automating_ETL_Pipelines_Using_Artificial_Intelligence_Transforming_Legacy_Data_Integration_Systems_into_Intelligent_Data_Workflows/links/684809cc8a76251f22ecc3e1/Automating-ETL-Pipelines-Using-Artificial-Intelligence-Transforming-Legacy-Data-Integration-Systems-into-Intelligent-Data-Workflows.pdf

Bình luận